#include <init.hpp>
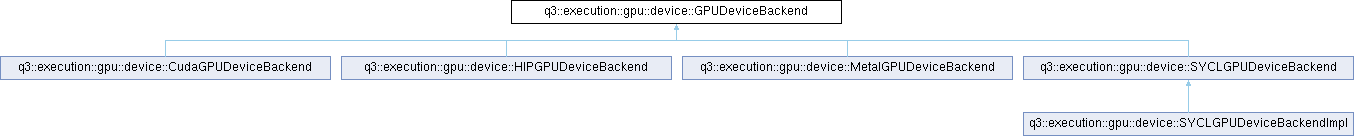
 Inheritance diagram for q3::execution::gpu::device::GPUDeviceBackend:
Public Member Functions | |
| virtual | ~GPUDeviceBackend ()=default |
| virtual void * | allocate_unified (size_t size_bytes)=0 |
| virtual void | deallocate (void *pointer)=0 |
| virtual std::string | device_name () const =0 |
| virtual bool | supports_double_precision () const =0 |
| virtual void | synchronize ()=0 |
| virtual size_t | total_memory_bytes () const =0 |
|
virtualdefault |
|
pure virtual |
Allocate unified (managed) memory accessible from both host and device.
On CUDA, this maps to cudaMallocManaged(). On Metal, this maps to MTLDevice::newBuffer() with MTLResourceStorageModeShared.
The returned memory is NOT zero-initialized.
| size_bytes | Number of bytes to allocate. |
| std::runtime_error | If allocation fails. |
Implemented in q3::execution::gpu::device::CudaGPUDeviceBackend, q3::execution::gpu::device::HIPGPUDeviceBackend, and q3::execution::gpu::device::SYCLGPUDeviceBackendImpl.
Referenced by q3::cli::validate_gpu_device_backend().
|
pure virtual |
Deallocate memory previously allocated via allocate_unified().
| pointer | Pointer returned by allocate_unified(). Must not be null. |
Implemented in q3::execution::gpu::device::CudaGPUDeviceBackend, q3::execution::gpu::device::HIPGPUDeviceBackend, and q3::execution::gpu::device::SYCLGPUDeviceBackendImpl.
Referenced by q3::cli::validate_gpu_device_backend().
|
pure virtual |
Human-readable name of the GPU device (e.g., "Apple M2 Max", "NVIDIA A100").
Implemented in q3::execution::gpu::device::CudaGPUDeviceBackend, q3::execution::gpu::device::HIPGPUDeviceBackend, and q3::execution::gpu::device::SYCLGPUDeviceBackendImpl.
Referenced by q3::cli::validate_gpu_device_backend().
|
pure virtual |
Whether the device supports native double precision (FP64) computation.
Returns false for Apple Silicon (Metal has no FP64 compute shaders). Returns true for CUDA GPUs (all supported compute capabilities).
Implemented in q3::execution::gpu::device::CudaGPUDeviceBackend, q3::execution::gpu::device::HIPGPUDeviceBackend, and q3::execution::gpu::device::SYCLGPUDeviceBackendImpl.
Referenced by q3::cli::validate_gpu_device_backend().
|
pure virtual |
Block until all pending GPU operations have completed.
Must be called before reading GPU-produced results on the host, and before precision casts or MPI collectives.
Implemented in q3::execution::gpu::device::CudaGPUDeviceBackend, q3::execution::gpu::device::HIPGPUDeviceBackend, and q3::execution::gpu::device::SYCLGPUDeviceBackendImpl.
|
pure virtual |
Total device memory in bytes.
Implemented in q3::execution::gpu::device::CudaGPUDeviceBackend, q3::execution::gpu::device::HIPGPUDeviceBackend, and q3::execution::gpu::device::SYCLGPUDeviceBackendImpl.
Referenced by q3::cli::validate_gpu_device_backend().
 1.9.8