#include <init.hpp>
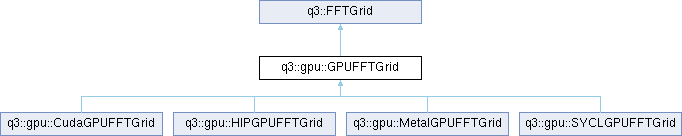
 Inheritance diagram for q3::gpu::GPUFFTGrid:
Public Member Functions | |
| GPUFFTGrid (std::shared_ptr< execution::gpu::device::GPUDeviceBackend > device_backend) | |
| ~GPUFFTGrid () override=default | |
| execution::gpu::device::GPUDeviceBackend & | device_backend () |
| const execution::gpu::device::GPUDeviceBackend & | device_backend () const |
| virtual void | forward_single (ComplexSingle *data) const =0 |
| virtual void | forward_single_batch (ComplexSingle *data, int batch_size) const |
| virtual void | forward_transform (Complex *data) const |
| virtual void | forward_transform_batch (Complex *data, int batch_size) const |
| virtual void | inverse_raw_single (ComplexSingle *data) const =0 |
| virtual void | inverse_raw_single_batch (ComplexSingle *data, int batch_size) const |
| virtual void | inverse_transform (Complex *data) const |
| virtual void | inverse_transform_batch (Complex *data, int batch_size) const |
| Public Member Functions inherited from q3::FFTGrid | |
| virtual | ~FFTGrid ()=default |
| virtual void | assign_sticks (const std::vector< int > &) |
| virtual bool | co_locates_mirrors () const |
| virtual int | concurrent_transform_slots () const |
| virtual void | execute_forward_on_buffers () const =0 |
| virtual void | execute_forward_on_slot (int) const |
Forward transform on slot slot, the slot-aware execute_forward_on_buffers(). | |
| virtual void | execute_inverse_raw_on_buffers () const =0 |
| virtual void | execute_inverse_raw_on_slot (int) const |
Inverse transform on slot slot, the slot-aware execute_inverse_raw_on_buffers(). | |
| virtual void | forward (Complex *data) const =0 |
| virtual void | forward_batched (Complex *data, int batch_size) const |
| virtual int | g_vector_to_fft_grid_index (int miller_1, int miller_2, int miller_3) const =0 |
| virtual void | gather_local_g_space (const Complex *full_g_space, Complex *local_g_space) const |
| virtual int | global_real_space_index (int local_index) const |
| virtual int | grid_dimension_1 () const =0 |
| virtual int | grid_dimension_2 () const =0 |
| virtual int | grid_dimension_3 () const =0 |
| virtual void | init (int dimension_1, int dimension_2, int dimension_3, bool use_measured_planning=false)=0 |
| virtual void | initialize_batched_plans (int, bool=false) const |
| virtual int | initialized_batched_plan_size () const |
| virtual Complex * | input_buffer () const =0 |
| virtual void | inverse (Complex *data) const =0 |
| virtual void | inverse_raw (Complex *data) const =0 |
| virtual void | inverse_raw_batched (Complex *data, int batch_size) const |
| virtual void | inverse_raw_on_slot (Complex *data, int) const |
| virtual int | local_g_space_points () const |
| virtual int | local_grid_points () const =0 |
| virtual int | local_offset () const =0 |
| virtual Complex * | output_buffer () const =0 |
| virtual bool | owns_stick (int, int) const |
| virtual void | prepare_forward_from_output () const =0 |
| virtual void | prepare_forward_from_output_on_slot (int) const |
Output-to-input copy on slot slot, the slot-aware prepare_forward_from_output(). | |
| virtual void | reduce_g_space (Complex *data, int number_of_elements) const =0 |
| virtual void | scatter_local_g_space (const Complex *local_g_space, Complex *full_g_space) const |
| The reverse: place this rank's reciprocal-space points into a full array. | |
| virtual int | slab_dimension_1 () const |
| virtual Complex * | slot_input_buffer (int) const |
| virtual Complex * | slot_output_buffer (int) const |
| virtual int | total_grid_points () const =0 |
Protected Attributes | |
| std::shared_ptr< execution::gpu::device::GPUDeviceBackend > | device_backend_ |
|
inlineexplicit |
Construct a GPU FFT grid backed by the given device.
FFT plans are created during init(), not in the constructor. The device backend is stored for memory management and synchronization.
| device_backend | Shared pointer to the GPU device backend. Must not be null. |
|
overridedefault |
|
inline |
Access the underlying GPU device backend.
Definition at line 162 of file init.hpp.
References device_backend_.
|
inline |
Access the underlying GPU device backend (const).
Definition at line 169 of file init.hpp.
References device_backend_.
|
pure virtual |
Forward single-precision FFT: real-space → reciprocal-space (unnormalized).
| data | In-out: single-precision complex grid data. |
Implemented in q3::gpu::CudaGPUFFTGrid, q3::gpu::HIPGPUFFTGrid, q3::gpu::MetalGPUFFTGrid, and q3::gpu::SYCLGPUFFTGrid.
Referenced by forward_single_batch().
|
inlinevirtual |
Batched forward single-precision FFT on multiple contiguous grids.
Each grid is total_grid_points() contiguous ComplexSingle values. Default loops over forward_single(); CUDA overrides with cufftPlanMany.
| data | Pointer to batch_size contiguous FFT grids. |
| batch_size | Number of grids to transform. |
Reimplemented in q3::gpu::CudaGPUFFTGrid, and q3::gpu::HIPGPUFFTGrid.
Definition at line 78 of file init.hpp.
References forward_single(), and q3::FFTGrid::total_grid_points().
Referenced by q3::GPUPlanewaveHamiltonianApplicator::apply_batch_single_precision().
|
inlinevirtual |
Forward FFT (FP64). On CUDA, delegates to cuFFT. On Metal, falls back to CPU FFTW since Apple GPUs lack native FP64 compute.
Default implementation delegates to the base FFTGrid (CPU FFTW). Subclasses with native FP64 GPU FFT support should override.
Reimplemented in q3::gpu::CudaGPUFFTGrid, q3::gpu::HIPGPUFFTGrid, and q3::gpu::SYCLGPUFFTGrid.
Definition at line 110 of file init.hpp.
References q3::FFTGrid::forward().
Referenced by forward_transform_batch().
|
inlinevirtual |
Batched forward FP64 FFT on multiple contiguous grids.
Each grid is total_grid_points() contiguous Complex values. Default loops over forward_transform(); CUDA overrides with cufftPlanMany.
| data | Pointer to batch_size contiguous FFT grids. |
| batch_size | Number of grids to transform. |
Reimplemented in q3::gpu::CudaGPUFFTGrid, and q3::gpu::HIPGPUFFTGrid.
Definition at line 136 of file init.hpp.
References forward_transform(), and q3::FFTGrid::total_grid_points().
|
pure virtual |
Inverse single-precision FFT without normalization (raw backward).
| data | In-out: single-precision complex grid data. |
Implemented in q3::gpu::CudaGPUFFTGrid, q3::gpu::HIPGPUFFTGrid, q3::gpu::MetalGPUFFTGrid, and q3::gpu::SYCLGPUFFTGrid.
Referenced by inverse_raw_single_batch().
|
inlinevirtual |
Batched inverse single-precision FFT on multiple contiguous grids.
Each grid is total_grid_points() contiguous ComplexSingle values. Default loops over inverse_raw_single(); CUDA overrides with cufftPlanMany.
| data | Pointer to batch_size contiguous FFT grids. |
| batch_size | Number of grids to transform. |
Reimplemented in q3::gpu::CudaGPUFFTGrid, and q3::gpu::HIPGPUFFTGrid.
Definition at line 94 of file init.hpp.
References inverse_raw_single(), and q3::FFTGrid::total_grid_points().
Referenced by q3::GPUPlanewaveHamiltonianApplicator::apply_batch_single_precision().
|
inlinevirtual |
Inverse FFT (FP64). On CUDA, delegates to cuFFT. On Metal, falls back to CPU FFTW since Apple GPUs lack native FP64 compute.
Default implementation delegates to the base FFTGrid (CPU FFTW). Subclasses with native FP64 GPU FFT support should override.
Reimplemented in q3::gpu::CudaGPUFFTGrid, q3::gpu::HIPGPUFFTGrid, and q3::gpu::SYCLGPUFFTGrid.
Definition at line 122 of file init.hpp.
References q3::FFTGrid::inverse_raw().
Referenced by inverse_transform_batch().
|
inlinevirtual |
Batched inverse FP64 FFT on multiple contiguous grids.
Each grid is total_grid_points() contiguous Complex values. Default loops over inverse_transform(); CUDA overrides with cufftPlanMany.
| data | Pointer to batch_size contiguous FFT grids. |
| batch_size | Number of grids to transform. |
Reimplemented in q3::gpu::CudaGPUFFTGrid, and q3::gpu::HIPGPUFFTGrid.
Definition at line 152 of file init.hpp.
References inverse_transform(), and q3::FFTGrid::total_grid_points().
|
protected |
Definition at line 174 of file init.hpp.
Referenced by device_backend(), and device_backend().
 1.9.8